Deux variables qui décideront si l’IA passe à côté de l’Afrique
Le FMI vient de publier son premier modèle économique sérieux de l'IA en Afrique subsaharienne, et le calcul est étonnamment facile à comprendre, même sans formation en économie. Il explique quelque chose sur quoi je travaille sous différents angles depuis quelques années.
Les deux chiffres qui comptent
Le FMI a fait tourner le même modèle de productivité que celui utilisé pour les États-Unis et l'Europe, mais pour l'Afrique subsaharienne.
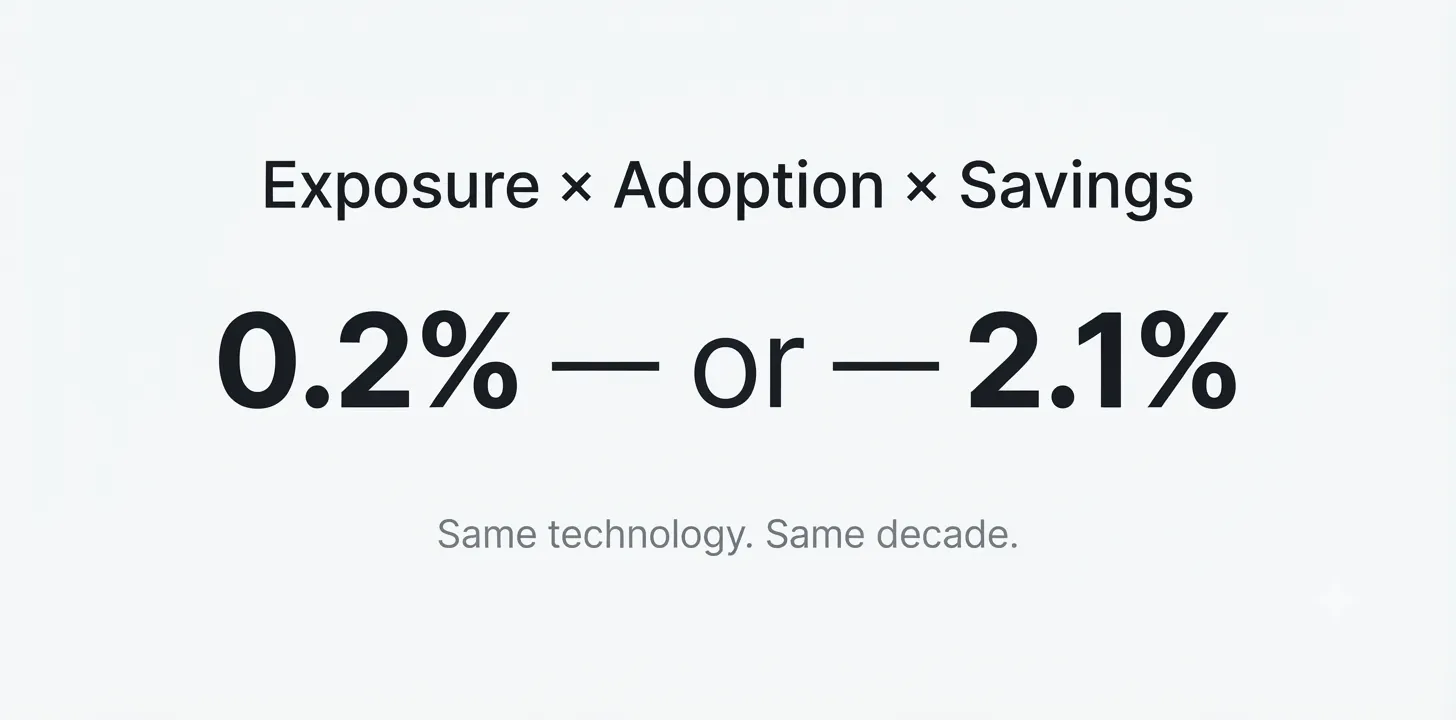
Dans les conditions actuelles, l'IA ajoute 0,2 % à la productivité de la région sur la prochaine décennie. Dans un scénario d'adoption élevée, ce chiffre devient 2,1 %, avec un effet sur le PIB d'environ 4 %.
C'est un écart de 10x. Même technologie, même région, même décennie.
Alors, qu'est-ce qui détermine le chiffre que vous obtenez ? Certainement pas la technologie. Ce sont les conditions qui l'entourent.
Pour voir pourquoi, il faut regarder à l'intérieur du modèle lui-même, et c'est plus simple qu'on ne le croirait.
Tout le modèle tient en trois chiffres multipliés entre eux
Retirez la notation, et le cadre du FMI dit que le gain de productivité égale :
Exposition × Adoption × Gains
- Exposition : quelle part du travail l'IA peut-elle réellement toucher ?
- Adoption : quelle part des entreprises l'utilise réellement ?
- Gains : quand elles l'utilisent, de combien chaque tâche devient-elle plus productive ?
La multiplication est la partie importante. Si l'un des trois chiffres est proche de zéro, le résultat entier est proche de zéro, et peu importe alors à quel point la technologie s'améliore.
Maintenant, insérez les chiffres actuels de l'Afrique subsaharienne :
- Exposition : seulement 22 % environ (0,22) des emplois sont significativement touchés par l'IA, contre à peu près 55 % en Europe.
- Adoption : moins de 10 % (0,1), deux à trois fois plus bas qu'en Europe ou dans les Amériques. Multipliez ces deux petits chiffres entre eux, puis par un gain par tâche d'environ 10 %, et vous atterrissez à 0,2 %.
L'équation vous dit exactement où se trouve le levier. On ne peut pas faire grand-chose sur le troisième chiffre, parce que les gains au niveau des tâches sont fixés par la technologie elle-même. Mais les deux premiers dépendent de nous. L'exposition et l'adoption ne sont pas des lois de la physique intouchables. Ce sont les résultats de décisions en matière d'infrastructure, de produits et de politiques publiques.
Tout ce sur quoi j'ai travaillé se situe quelque part dans ces deux variables.
Pensez à l'IA comme à des outils électriques dans un village sans électricité
Imaginez expédier un conteneur d'outils électriques dans un village sans réseau.
Les outils fonctionnent parfaitement. Les gens sont qualifiés. Mais rien ne se passe, parce que les outils ont besoin de quelque chose que l'environnement ne fournit pas encore.
C'est la variable d'adoption sous forme physique. L'IA augmente la productivité quand elle est associée à une énergie fiable, à la connectivité, aux compétences et aux institutions.
Les économistes appellent cela des « conditions complémentaires », mais j'aime y penser comme au réseau. Et le problème du réseau n'est pas abstrait. Soixante-dix-huit pour cent des entreprises de la région signalent des coupures de courant routinières, perdant 8,4 % de leurs ventes annuelles contre une moyenne mondiale de 5,2 %. Quatre-vingt-six pour cent des entreprises nigérianes possèdent ou partagent un groupe électrogène.
Quand votre point de départ est « le courant ne sera peut-être pas là », un outil dépendant du cloud est difficile à vendre, aussi impressionnante que soit la démo.
Le chiffre de « faible exposition » est en partie un artefact de mesure
C'est ici que ça devient intéressant, et où je pense que le rapport du FMI contredit discrètement son propre chiffre phare.
La mesure de l'exposition fonctionne en décomposant les emplois en tâches et en demandant : l'IA actuelle peut-elle faire cette tâche ?
Par cette méthode, l'agriculture obtient un score proche de zéro, parce que les tâches d'un agriculteur sont surtout physiques… L'IA ne peut pas planter du maïs, n'est-ce pas ?
Mais regardez ce qui se passe quand on pose une autre question : non pas « l'IA peut-elle faire les tâches de l'agriculteur ? » mais « l'IA peut-elle combler les déficits d'information de l'agriculteur ? »
Les rendements agricoles typiques de la région tournent à 25–33 % du potentiel. Ça n'a jamais été une question de compétence… c'est simplement qu'ils manquent d'information en temps réel sur la météo, les sols, les ravageurs, les prix et le calendrier. Un essai randomisé d'un service de conseil par SMS propulsé par l'IA a constaté une hausse de rendement de 16,6 % et une hausse de revenu de 23 % en une seule saison. Par SMS. Sur des téléphones basiques. Sans réseau électrique.
Le FMI a fait passer cette logique dans son propre modèle. Étendre l'IA à la seule agriculture ajoute 0,8 point de pourcentage — le plus grand levier isolé de tout le cadre, quatre fois la taille du total dans les conditions actuelles.
L'exposition ne tient pas au métier lui-même. Elle tient à la manière dont on livre l'intelligence.
Quand on mesure l'agriculture par l'automatisation des tâches, elle n'est pas exposée ; mais quand on la mesure par l'aide à la décision, elle devient la plus grande opportunité du continent.
Le même recadrage s'applique au commerce informel — gardez cette idée en tête.
Suivez l'argent : le piège du consommateur
Avant la partie optimiste, il faut rester un moment avec la partie inconfortable. C'est la section où je veux que vous en sentiez le poids.
Disons qu'une entreprise de Lagos adopte des outils d'IA et devient 20 % plus productive. Bon résultat, non ? Maintenant, suivez où va l'argent.
L'abonnement est facturé en dollars. Le modèle tourne sur des serveurs en Virginie ou à Dublin. Les puces viennent d'une seule entreprise, le cloud de trois. Alors chaque mois, une entreprise qui gagne en nairas convertit en dollars et envoie de la valeur vers le haut d'une pile à laquelle elle ne participe pas — à aucune couche.
Maintenant, multipliez cela à l'échelle d'une économie. Des millions d'entreprises, toutes plus productives, toutes convertissant la monnaie locale en dollars pour le même intrant importé.
Individuellement, c'est très rationnel. Collectivement, c'est une pression soutenue sur le taux de change, et une dépendance structurelle croissante envers une infrastructure facturée dans la monnaie de quelqu'un d'autre et gouvernée par les règles de quelqu'un d'autre.
C'est ce que j'entends par la différence entre consommer l'IA et y participer. Une relation de consommation concentre les gains au point de production et les extrait du point d'usage. On a déjà vu cette boucle — les matières premières qui sortent, les produits finis qui rentrent, la valeur captée ailleurs. La marchandise, cette fois, c'est l'intelligence, mais la géométrie est ancienne.
Le FMI le dit dans un langage institutionnel : dépendance envers des fournisseurs étrangers, infrastructure « coûteuse, concentrée et façonnée par la fragmentation géopolitique ». J'en ai parlé dans un langage plus direct ici.
Dans tous les cas, le gain de productivité est réel et l'extraction est réelle. Les deux choses sont vraies en même temps, et toute stratégie honnête doit tenir les deux.
La gouvernance est une position de négociation, pas un règlement
C'est la question qui a produit NEAIF, le cadre de gouvernance de l'IA que j'ai publié pour le contexte nigérian.
La plupart des cadres de gouvernance partent du déploiement : les systèmes existent, les gens les utilisent, comment réguler ? Si cela ressemble à la meilleure question pour Bruxelles, c'est la mauvaise première question pour Abuja, parce qu'elle suppose que vous avez déjà un levier sur les systèmes, ce qui n'est pas le cas.
Imaginez-vous arriver à une négociation commerciale sans rien que l'autre partie désire. Les gens vendent des réacteurs d'avion, des drones longue portée, des puces de silicium, des abonnements SaaS d'entreprise, et tout ce que vous avez, c'est une « population croissante au potentiel immense » et un stock déclinant de cacao brut.
Vous pouvez écrire toutes les règles que vous voulez. Personne n'a de raison de s'asseoir à votre table, sauf s'il y a une occasion d'exploitation.
Qu'est-ce qui vous donne un siège ? Surtout, les données. Les systèmes d'IA sont affamés de données qu'ils n'ont pas — langues locales, schémas de commerce locaux, conditions agricoles locales. Un pays qui contrôle des jeux de données locaux de haute qualité et bien gouvernés a quelque chose à échanger. Un pays qui n'en a pas est un preneur de règles.
C'est l'argument de Governing by Data, le cadre compagnon de NEAIF : construisez d'abord la position sur les données, parce qu'elle transforme la gouvernance d'un exercice de conformité en monnaie d'échange.
Je me suis trompé sur certains points, d'ailleurs. J'ai sous-estimé le temps qu'il faut au travail de gouvernance pour gagner du terrain sans soutien institutionnel, et j'ai appris qu'être en avance et être lisible sont deux choses très différentes. Que le FMI modélise maintenant ce même terrain ne prouve pas automatiquement que les cadres avaient raison, mais cela montre fortement que la conversation a enfin un point de référence commun.
Ce que nous enseigne l'histoire du mobile money
Voici maintenant la partie encourageante, et nous allons en discuter avec l'exemple du FMI lui-même.
L'Afrique subsaharienne n'a jamais construit de réseaux de téléphonie fixe à grande échelle. Les téléphones mobiles sont arrivés, et la région a entièrement sauté l'ère du fixe. Aujourd'hui, elle détient 1,2 milliard des 2,1 milliards de comptes de mobile money enregistrés dans le monde.
Le leader mondial a été bâti par-dessus une couche sautée.
Le mécanisme compte plus que le résultat. M-Pesa a fonctionné parce qu'il rejoignait les gens exactement là où ils étaient : téléphones basiques, économies de cash, pas de comptes bancaires. Il ne demandait pas aux utilisateurs de devenir d'abord « bancarisés ». Il a rendu l'ancien prérequis inutile.
C'est le schéma de conception : ne traînez pas les gens dans l'ancien escalier. Construisez le nouveau plancher sous leurs pieds.
Construire pour la couche en formation
Appliquez ce schéma au commerce, et vous obtenez le pari derrière Paylo.
Imaginez une commerçante qui vend des chaussures à Aba. Elle est douée dans son métier. Toute son existence commerciale passe par WhatsApp et les transferts d'argent.
Selon la mesure du FMI, son métier a une exposition à l'IA proche de zéro. L'ère du e-commerce l'a largement sautée, parce que les sites web coûtaient trop cher, que les plateformes prenaient trop, et que la logistique centralisée n'arrivait pas jusqu'à elle.
Voici ce qui change sous ses pieds : les gens commencent à demander à des assistants IA quoi acheter. « Où puis-je trouver des chaussures en cuir de qualité près de chez moi ? » Quand cette question est posée, l'IA répond à partir des données commerciales structurées auxquelles elle peut accéder. Aujourd'hui, notre commerçante n'existe pas dans cette réponse, tout simplement parce qu'elle n'a aucune surface que l'IA puisse voir. Rien de dramatique ne lui arrive encore, mais chaque acheteur qui interroge une IA au lieu de demander autour de lui est un acheteur dont elle n'a jamais su qu'il existait.
Alors c'est ce que nous construisons. Paylo lui donne une vitrine qui est d'abord de la donnée structurée, et une page web ensuite. Nous faisons tourner un serveur MCP — une interface standard qui permet aux systèmes d'IA d'interroger directement notre catalogue de commerçants, comme les applications interrogent une base de données. Nous détectons les plateformes d'IA qui frappent à l'API, pour voir la couche de découverte se former en temps réel.
Remarquez ce que la commerçante doit apprendre sur l'IA pour que cela fonctionne : absolument rien.
Elle met ses chaussures en ligne. La couche fait le reste — de la même manière qu'un utilisateur de M-Pesa n'a jamais eu besoin de comprendre l'infrastructure des télécoms. Dans les termes du modèle, nous n'attendons pas qu'elle devienne exposée. Nous fabriquons l'exposition et nous la lui remettons.
Et remarquez ce que cela fait à la boucle d'extraction de tout à l'heure. La découverte se fait sur des modèles étrangers — cette couche que nous ne contrôlons pas encore. Mais la relation avec la commerçante, la transaction, les données commerciales, les rails locaux ? Tout cela reste à la maison. C'est une position de participation, pas de consommation. Partielle, imparfaite, mais structurellement différente.
La fenêtre est réelle
La conclusion du FMI est sans détour : l'écart entre les trajectoires est de 10x, la trajectoire par défaut est la basse, et les choix faits en ce moment même décident de celle qui l'emportera.
Les fenêtres comme celle-ci ne restent pas ouvertes. Les effets de réseau et les économies d'échelle font que les positions précoces se composent — le rapport lui-même avertit que les industries numériques se concentrent, et que les retardataires finissent par louer l'infrastructure des premiers arrivés. Chaque année de dérive rend la trajectoire basse plus difficile à quitter.
Je trouve cela clarifiant plutôt qu'alarmant, parce que cela rend le travail lisible.
- Déplacer le chiffre d'adoption : réseau électrique, connectivité, produits qui survivent à une coupure de courant.
- Déplacer le chiffre d'exposition : construire des surfaces là où la mesure dit qu'il n'y a rien.
- Conserver les gains : des positions sur les données et une gouvernance qui vous donnent de quoi négocier.
Différentes personnes travaillent sur différentes pièces. Les cadres en sont une, les produits en sont une autre, et coucher la structure par écrit en est une troisième.
Rien de tout cela n'est terminé, alors il est important de prendre le rapport du FMI pour ce qu'il est : un point de données qui rend la conversation plus facile à avoir, plutôt qu'une sombre conclusion sur notre avenir collectif.
Ce texte fait la paire avec Infrastructure doesn't pitch well, yet it wins anyway. C'est la même fenêtre, vue du côté du capital.